Étape 8 : Ajout des nodes au cluster avec kubeadm join
Introduction
Le précédent article traitait du rôle d’Ansible xkub_kubeadm_init, qui s’occupe de l’initialisation du cluster K8S en lançant la commande kubeadm init sur le premier nœud control plane du cluster (prdk8sgru501).
La suite logique est maintenant de passer à l’ajout des nodes restants via le rôle xkub_kubeadm_join.
Pour rappel, celui-ci est toujours appelé par même le playbook xkub_30_cluster.yml chargé déjà de lancer dans l’ordre le rôle xkub_kube_vip, puis xkub_kubeadm_init et maintenant xkub_kubeadm_join.
Le rôle xkub_kubeadm_join
Rentrons directement dans le vif du sujet avec la présentation détaillée du rôle en question en explorant son arborescence.
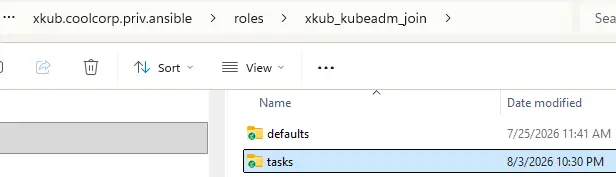
Cliquez sur l'image pour l'agrandir.
Les variables du rôle
On démarre comme d’habitude avec le dossier « defaults » pour identifier les variables du rôle déclarées dans le fichier main.yml
---
# Rôle xkub_kubeadm_join — fait rejoindre un nœud au cluster (control plane
# additionnel ou worker) puis pose ses labels/taints. Idempotent : ne rejoint
# rien si le nœud est déjà membre (test sur /etc/kubernetes/kubelet.conf).

# Hôte "source de vérité" pour le token/certificate-key générés par le rôle
# xkub_kubeadm_init (inventory/group_vars/clu_k8s_xkub/main.yml), et hôte délégué pour
# toutes les opérations kubernetes.core.k8s de ce rôle.
xkub_kubeadm_join_primary_controlplane: "{{ xkub_primary_control_plane }}"

# Groupes d'inventaire traités comme "workers" pour le join. Liste dupliquée
# volontairement de xkub_k8s_prereqs_worker_groups (roles/xkub_k8s_prereqs/defaults) —
# les deux rôles restent indépendants, chacun avec sa propre source de vérité.
xkub_kubeadm_join_worker_groups:
  - k8s_workers_lan
  - k8s_workers_web
  - gpu

# Attente de l'enregistrement du Node auprès de l'API avant labellisation
# (30 tentatives x 5s = 150s d'attente maximum).
xkub_kubeadm_join_node_wait_retries: 30
xkub_kubeadm_join_node_wait_delay: 5

# Filets de sécurité si un groupe n'a pas (encore) de group_vars dédié
# (ex. futur groupe sans fichier créé) : un patch avec ces valeurs par défaut
# ne fait rien (dict/liste vides), au lieu de faire échouer le rôle.
k8s_node_labels: {}
k8s_node_taints: []
roles/xkub_kubeadm_join/defaults/main.yml
La variable xkub_kubeadm_join_primary_controlplane se réfère à la variable globale xkub_primary_control_plane, définie dans le fichier inventory/group_vars/all/main.yml. Cette dernière fait elle-même appel à un filtre dans l’inventaire grâce à l’instruction « {{ groups['k8s_controlplane_lan'] | sort | first }} » pour identifier notre premier control plane, celui rattaché au rôle précédent xkub_kubeadm_init pour initialiser le cluster, soit prdk8sgru501.
---
# =============================================================================
# group_vars/all — UNIQUEMENT ce qui doit être résolu au niveau `all`.
# Tout le reste des variables du cluster xkub vit dans
# inventory/group_vars/clu_k8s_xkub/ (portée limitée aux hôtes du cluster,
# indispensable pour cohabiter avec d'autres déploiements dans un dépôt
# Ansible mutualisé). Préfixe obligatoire ici : xkub_* (namespace du cluster).
# =============================================================================

# --- Nœud de référence pour les opérations kubernetes.core (phase 4+) --------
# `kubeadm init` s'exécute sur ce seul nœud, qui sert ensuite d'hôte délégué
# (delegate_to) pour toutes les opérations kubernetes.core.k8s/helm du projet
# (jamais depuis le poste de contrôle W11). Convention identique à
# `xkub_haproxy_keepalived_is_master` (roles/xkub_haproxy_keepalived/defaults) :
# premier nom d'hôte du groupe par tri alphabétique, donc prdk8sgru501.
# DOIT rester dans group_vars/all : cette variable est utilisée pour templater
# le motif `hosts:` des plays (playbooks/xkub_30_cluster.yml), résolu AVANT la
# sélection des hôtes — les group_vars d'un groupe ne sont pas disponibles à
# ce stade.
xkub_primary_control_plane: "{{ groups['k8s_controlplane_lan'] | sort | first }}"
inventory/group_vars/all/main.yml
Il est nécessaire de l’avoir en tête, car il sert de référence pour le passage des commandes postinitialisation et des contrôles tiers.
La variable xkub_kubeadm_join_worker_groups contient la liste de tous les groupes qui référencent les serveurs à ajouter aux clusters. On y retrouve donc les workers du lan, les worker en dmz web et le worker gpu lié au serveur physique équipé d’un GPU.
Le reste des variables sont propres à des paramètres spécifiques pour éviter des erreurs ou spécifier des timeouts.
Ansible devra se connecter sur chacun des nœuds qui vont se joindre au cluster pour lancer la commande kubeadm join. Selon qu’il s’agit d’ajouter un contrôleur ou d'un worker, cela prendra plus ou moins de temps, le second s’ajoutant effectivement plus rapidement que le premier (moins de dépendances à exécuter).
Les tasks
On peut poursuivre par l’exploration du dossier tasks
main.yml
Celui-ci contient, comme d’habitude, le fichier de base main.yml, qui liste l’ordre des tâches en faisant référence aux autres fichiers détaillant les actions à réaliser.
---
# Rôle xkub_kubeadm_join — appliqué à k8s_controlplane_lan (CP2/CP3, CP1 y compris
# mais sans effet — cf. ci-dessous), k8s_workers_lan, k8s_workers_web et gpu.
- name: Déterminer si ce nœud est déjà membre du cluster
  ansible.builtin.stat:
    path: /etc/kubernetes/kubelet.conf
  register: xkub_kubeadm_join_kubelet_conf
  tags:
    - xkub
    - xkub.kubeadm_join
    - xkub.kubeadm_join.check

# Sans effet sur xkub_primary_control_plane (déjà initialisé par xkub_kubeadm_init)
# et sur tout nœud déjà membre : les deux conditions sont vérifiées dans le
# fichier de tâches lui-même.
- name: Rejoindre un control plane additionnel (CP2/CP3)
  ansible.builtin.import_tasks: 01_join_controlplane.yml
  tags:
    - xkub
    - xkub.kubeadm_join
    - xkub.kubeadm_join.controlplane

- name: Rejoindre un worker
  ansible.builtin.import_tasks: 02_join_worker.yml
  tags:
    - xkub
    - xkub.kubeadm_join
    - xkub.kubeadm_join.worker

# Appliqué à TOUS les nœuds du play, y compris xkub_primary_control_plane —
# c'est ainsi que ce nœud reçoit lui aussi son label roles=control-plane.
- name: Labels et taints du nœud (D3 — isolation DMZ)
  ansible.builtin.import_tasks: 03_labels_taints.yml
  tags:
    - xkub
    - xkub.kubeadm_join
    - xkub.kubeadm_join.labels
roles/xkub_kubeadm_join/tasks/main.yml
01_join_controlplane.yml
On peut donc directement passer au fichier 01_join_controlplane.yml
---
# CP2/CP3 uniquement : le premier control plane est initialisé par le rôle
# xkub_kubeadm_init, jamais rejoint via cette tâche (double garde ci-dessous :
# comparaison explicite ET test kubelet.conf, qui serait de toute façon vrai
# sur xkub_primary_control_plane).
# --apiserver-advertise-address : IP du nœud, jamais la VIP (même principe que
# kubeadm-config.yaml.j2 côté xkub_kubeadm_init).
- name: kubeadm join --control-plane (CP2/CP3)
  ansible.builtin.command:
    cmd: >-
      {{ hostvars[xkub_kubeadm_join_primary_controlplane].xkub_kubeadm_init_join_command }}
      --control-plane
      --certificate-key {{ hostvars[xkub_kubeadm_join_primary_controlplane].xkub_kubeadm_init_certificate_key }}
      --apiserver-advertise-address {{ ansible_host }}
  when:
    - "'k8s_controlplane_lan' in group_names"
    - inventory_hostname != xkub_kubeadm_join_primary_controlplane
    - not xkub_kubeadm_join_kubelet_conf.stat.exists
  changed_when: true
  no_log: true
roles/xkub_kubeadm_join/tasks/01_join_controlplane.yml
Ce premier fichier est dédié à l’ajout des control plane. Via le filtre "'k8s_controlplane_lan' in group_names", la commande kubeadm join --control-plane, ne vas cibler que les VMs prdk8sgruxxx, en vérifiant que ces dernières ne contiennent pas de configuration existante (not xkub_kubeadm_join_kubelet_conf.stat.exists) et qu’elles ne correspondent pas à notre premier control plane (inventory_hostname != xkub_kubeadm_join_primary_controlplane) ayant servis à l’initialisation dans le rôle précédent.
La commande kubeadm join --control-plane va être complétée des variables issues justement du rôle précédent (xkub_kubeadm_init) pour se présenter à l’API exécuté sur le premier node avec les bonnes informations d’authentification.
En effet, rappelez-vous que le rôle précédent utiliser l’instruction « set_fact » pour capturer les informations nécessaires en tant que variable afin qu’elles puissent être réutilisées durant toute la durée du playbook.
Principes d’ajout d’un node à un cluster
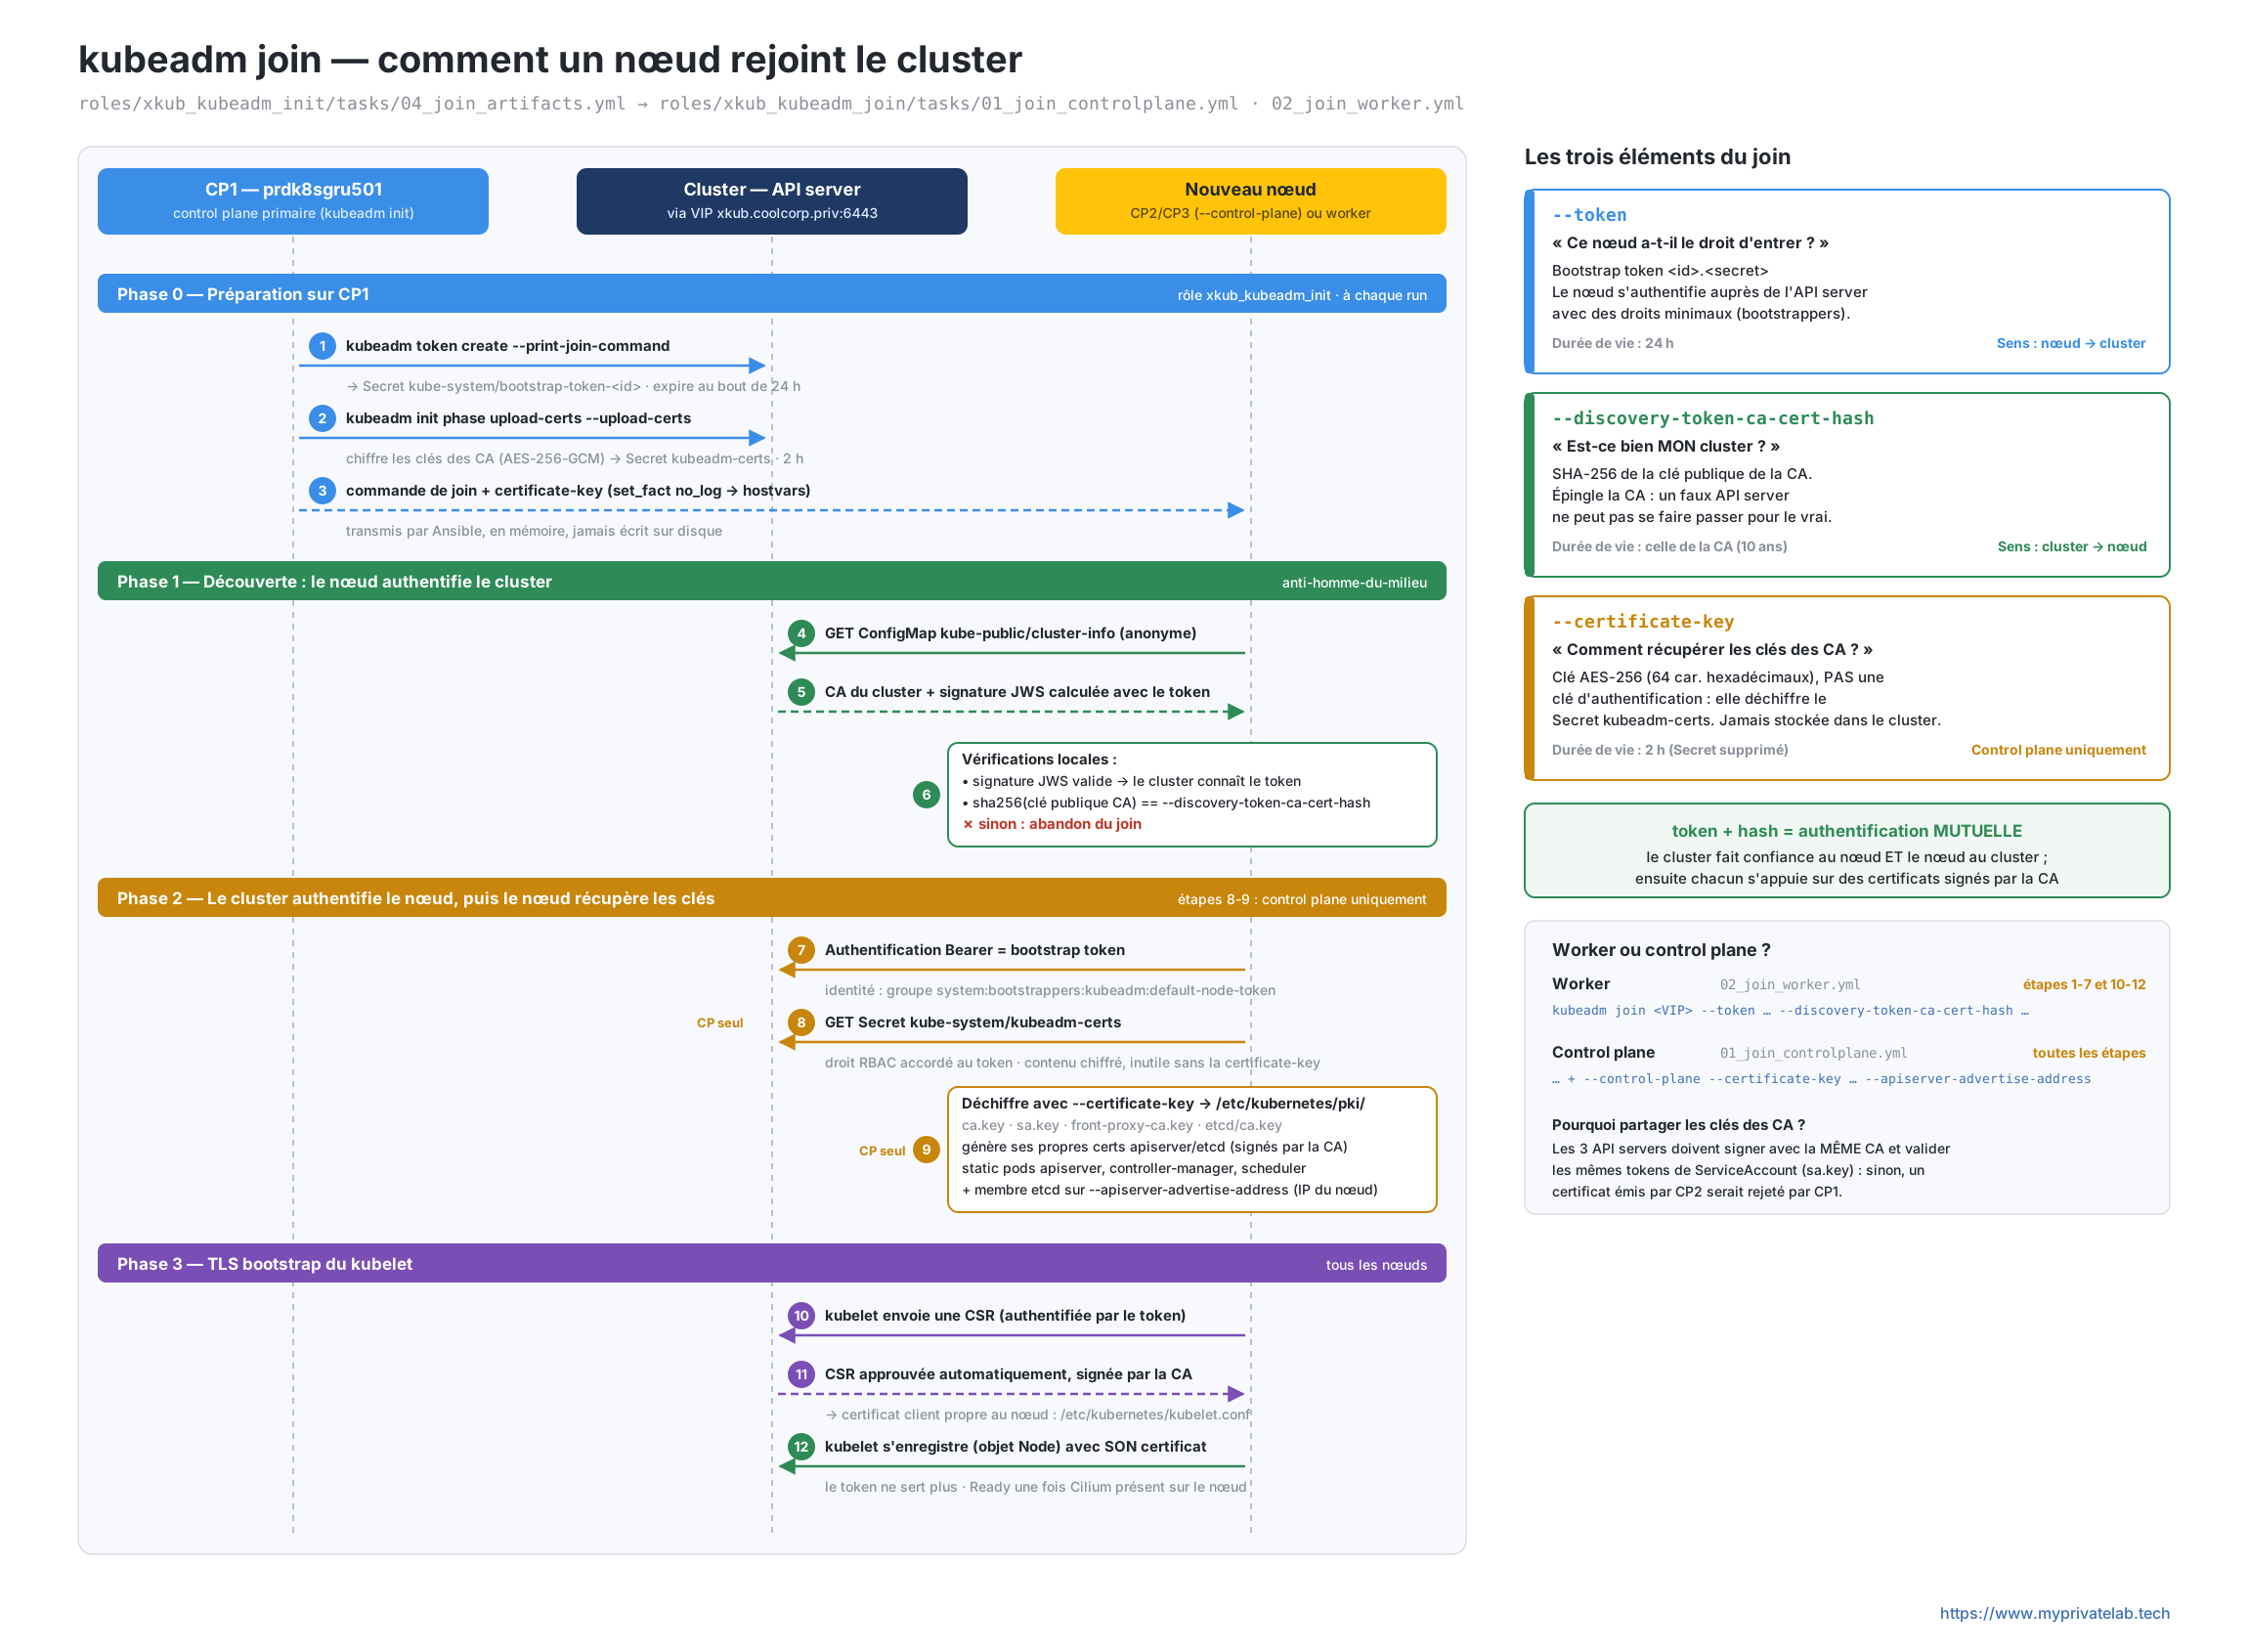
Profitons-en pour voir le mécanisme qui entre en jeu lorsqu’un serveur rejoint un cluster Kubernetes.
Pour s’enregistrer, un nœud type control plane a besoin de quatre informations :
- L’URL de l’API (incluant le port) pour savoir à qui s’adresser, en l’occurrence ici on force vers le premier control plane (dont le nom est déclaré dans le certificat de l’API, donc on est correcte)
- Un token d’accès, soit le token délivré lors de l’étape précédente et dont la validité n’est que de 24h par défaut (ce qui n’est pas un souci ici puisqu’on va dérouler l’ensemble des opérations lors de l’appel au playbook qui va appeler les rôles les uns à la suite des autres)
- Le hash SHA-256 de la clef publique associé au CA interne du cluster, cela pour garantir qu’il s’adresse au bon cluster pour s’enregistrer.
- La clé de chiffrement afin de récupérer les mêmes clefs privées d’autorité de certification sur chaque control plane (Cette partie n'est pas nécessaire pour un worker)
Grâce à l’IA, voici un schéma qui explique le processus au complet.
Cliquez sur l'image pour l'agrandir.
En résumé, il est important de comprendre que tous les échanges internes au cluster entre les nœuds empruntent des canaux chiffrés et basés sur une CA interne au cluster et mise en œuvre lors de l’initialisation du premier control plane. La gestion de cette CA est d’ailleurs une charge de chaque control plane d’où l’obligation pour ces derniers de partager les clefs privées associées.
Cette méthode permet d’authentifier dans les deux sens les échanges entre composants.
D’ailleurs le suivi de la validité des certificats associés à cette CA intégrée est très important dans le monitoring d’un cluster.
02_join_worker.yml
On peut maintenant enchainer avec le fichier 02_join_worker.yml dédié à l’intégration des workers
---
# Workers
- name: kubeadm join (worker)
  ansible.builtin.command:
    cmd: "{{ hostvars[xkub_kubeadm_join_primary_controlplane].xkub_kubeadm_init_join_command }}"
  when:
    - xkub_kubeadm_join_worker_groups | intersect(group_names) | length > 0
    - not xkub_kubeadm_join_kubelet_conf.stat.exists
  changed_when: true
  no_log: true
roles/xkub_kubeadm_join/tasks/02_join_worker.yml
Ici aussi on joue une commande kubeadm join, mais avec moins d’arguments, puisqu’il ne s’agit pas de control plane. Inutile donc d’initier des composants comme l’api serveur ou de se partager des éléments rattachés à la gestion de la CA interne.
Le schéma précédent reste valable, il est juste simplifié avec moins de composants à démarrer sur ces nodes.
03_labels_taints.yml
On enchaine avec le dernier fichier 03_labels_taints.yml
---
# Appliqué à TOUS les nœuds à CHAQUE exécution : un patch Kubernetes est par
# nature idempotent (le module kubernetes.core.k8s ne remonte "changed" que
# s'il y a une réelle divergence), ce qui garantit que les labels/taints
# restent conformes même après une modification manuelle sur le cluster.
# Exécuté depuis xkub_primary_control_plane (kubeconfig local)
- name: Attendre l'enregistrement du nœud auprès de l'API
  kubernetes.core.k8s_info:
    kubeconfig: /etc/kubernetes/admin.conf
    kind: Node
    name: "{{ inventory_hostname }}"
  delegate_to: "{{ xkub_kubeadm_join_primary_controlplane }}"
  register: xkub_kubeadm_join_node_info
  until: xkub_kubeadm_join_node_info.resources | length > 0
  retries: "{{ xkub_kubeadm_join_node_wait_retries }}"
  delay: "{{ xkub_kubeadm_join_node_wait_delay }}"

- name: Poser les labels du nœud
  kubernetes.core.k8s:
    kubeconfig: /etc/kubernetes/admin.conf
    kind: Node
    name: "{{ inventory_hostname }}"
    state: patched
    definition:
      metadata:
        labels: "{{ k8s_node_labels }}"
  delegate_to: "{{ xkub_kubeadm_join_primary_controlplane }}"
  when: k8s_node_labels | length > 0

# Contrepartie indispensable de la tâche précédente : un patch FUSIONNE les
# labels, il n'en retire jamais.
- name: Retirer les labels obsolètes du nœud
  kubernetes.core.k8s:
    kubeconfig: /etc/kubernetes/admin.conf
    kind: Node
    name: "{{ inventory_hostname }}"
    state: patched
    definition:
      metadata:
        labels: "{{ k8s_node_labels_absent }}"
  delegate_to: "{{ xkub_kubeadm_join_primary_controlplane }}"
  when: k8s_node_labels_absent | length > 0

- name: Poser les taints du nœud (D3 — isolation DMZ, jamais retiré pour contourner un souci de scheduling)
  kubernetes.core.k8s:
    kubeconfig: /etc/kubernetes/admin.conf
    kind: Node
    name: "{{ inventory_hostname }}"
    state: patched
    definition:
      spec:
        taints: "{{ k8s_node_taints }}"
  delegate_to: "{{ xkub_kubeadm_join_primary_controlplane }}"
  when: k8s_node_taints | length > 0
roles/xkub_kubeadm_join/tasks/03_labels_taints.yml
C’est ici qu’on va fixer les labels et les taints de chaque node propre à nos choix d’architecture établis en préambule de ce cookbook.
---
# Control planes (prdk8sgru501/502/503)
k8s_node_labels:
  roles: control-plane
k8s_node_taints: []
inventory/group_vars/k8s_controlplane_lan.yml
---
# Workers LAN (prdk8smin501/502)
k8s_node_labels:
  network: lan
  roles: worker-lan
  node-role.kubernetes.io/worker-lan: ""
k8s_node_taints: []

k8s_node_labels_absent:
  node-role.kubernetes.io/worker: null
inventory/group_vars/k8s_workers_lan.yml
---
# Workers DMZ (prdk8smin510/511)
k8s_node_labels:
  network: dmz
  roles: worker-dmz
  node-role.kubernetes.io/worker-dmz: ""

k8s_node_labels_absent:
  node-role.kubernetes.io/worker: null
k8s_node_taints:
  - key: network
    value: dmz
    effect: NoSchedule
inventory/group_vars/k8s_workers_web.yml
Principe des labels et des taints
Rappelez-vous que Kubernetes permet d’organiser ses nodes en fonction de ses besoins pour dédier telles ou telles nodes à tels usages. Cela permet d’optimiser ses ressources et de répondre aux mieux à certaines contraintes d’isolation, de disponibilité ou de performances.
De bases il y a déjà une distinction entre les nœuds control plane dédiés à la gestion du cluster, des nœuds worker dédiés à l’exécution des assets. D’ailleurs dans ce cas par défaut, un control plane se retrouve avec des taints qui bloques le lancement des applications pour éviter qu’ils ne soient utilisés pour autres choses que leur rôle de départ.
Ces distinctions s’opèrent via des labels et des taints. Ce sont deux principes différents, qui n’ont pas les mêmes objectifs, mais qui sont complémentaires.
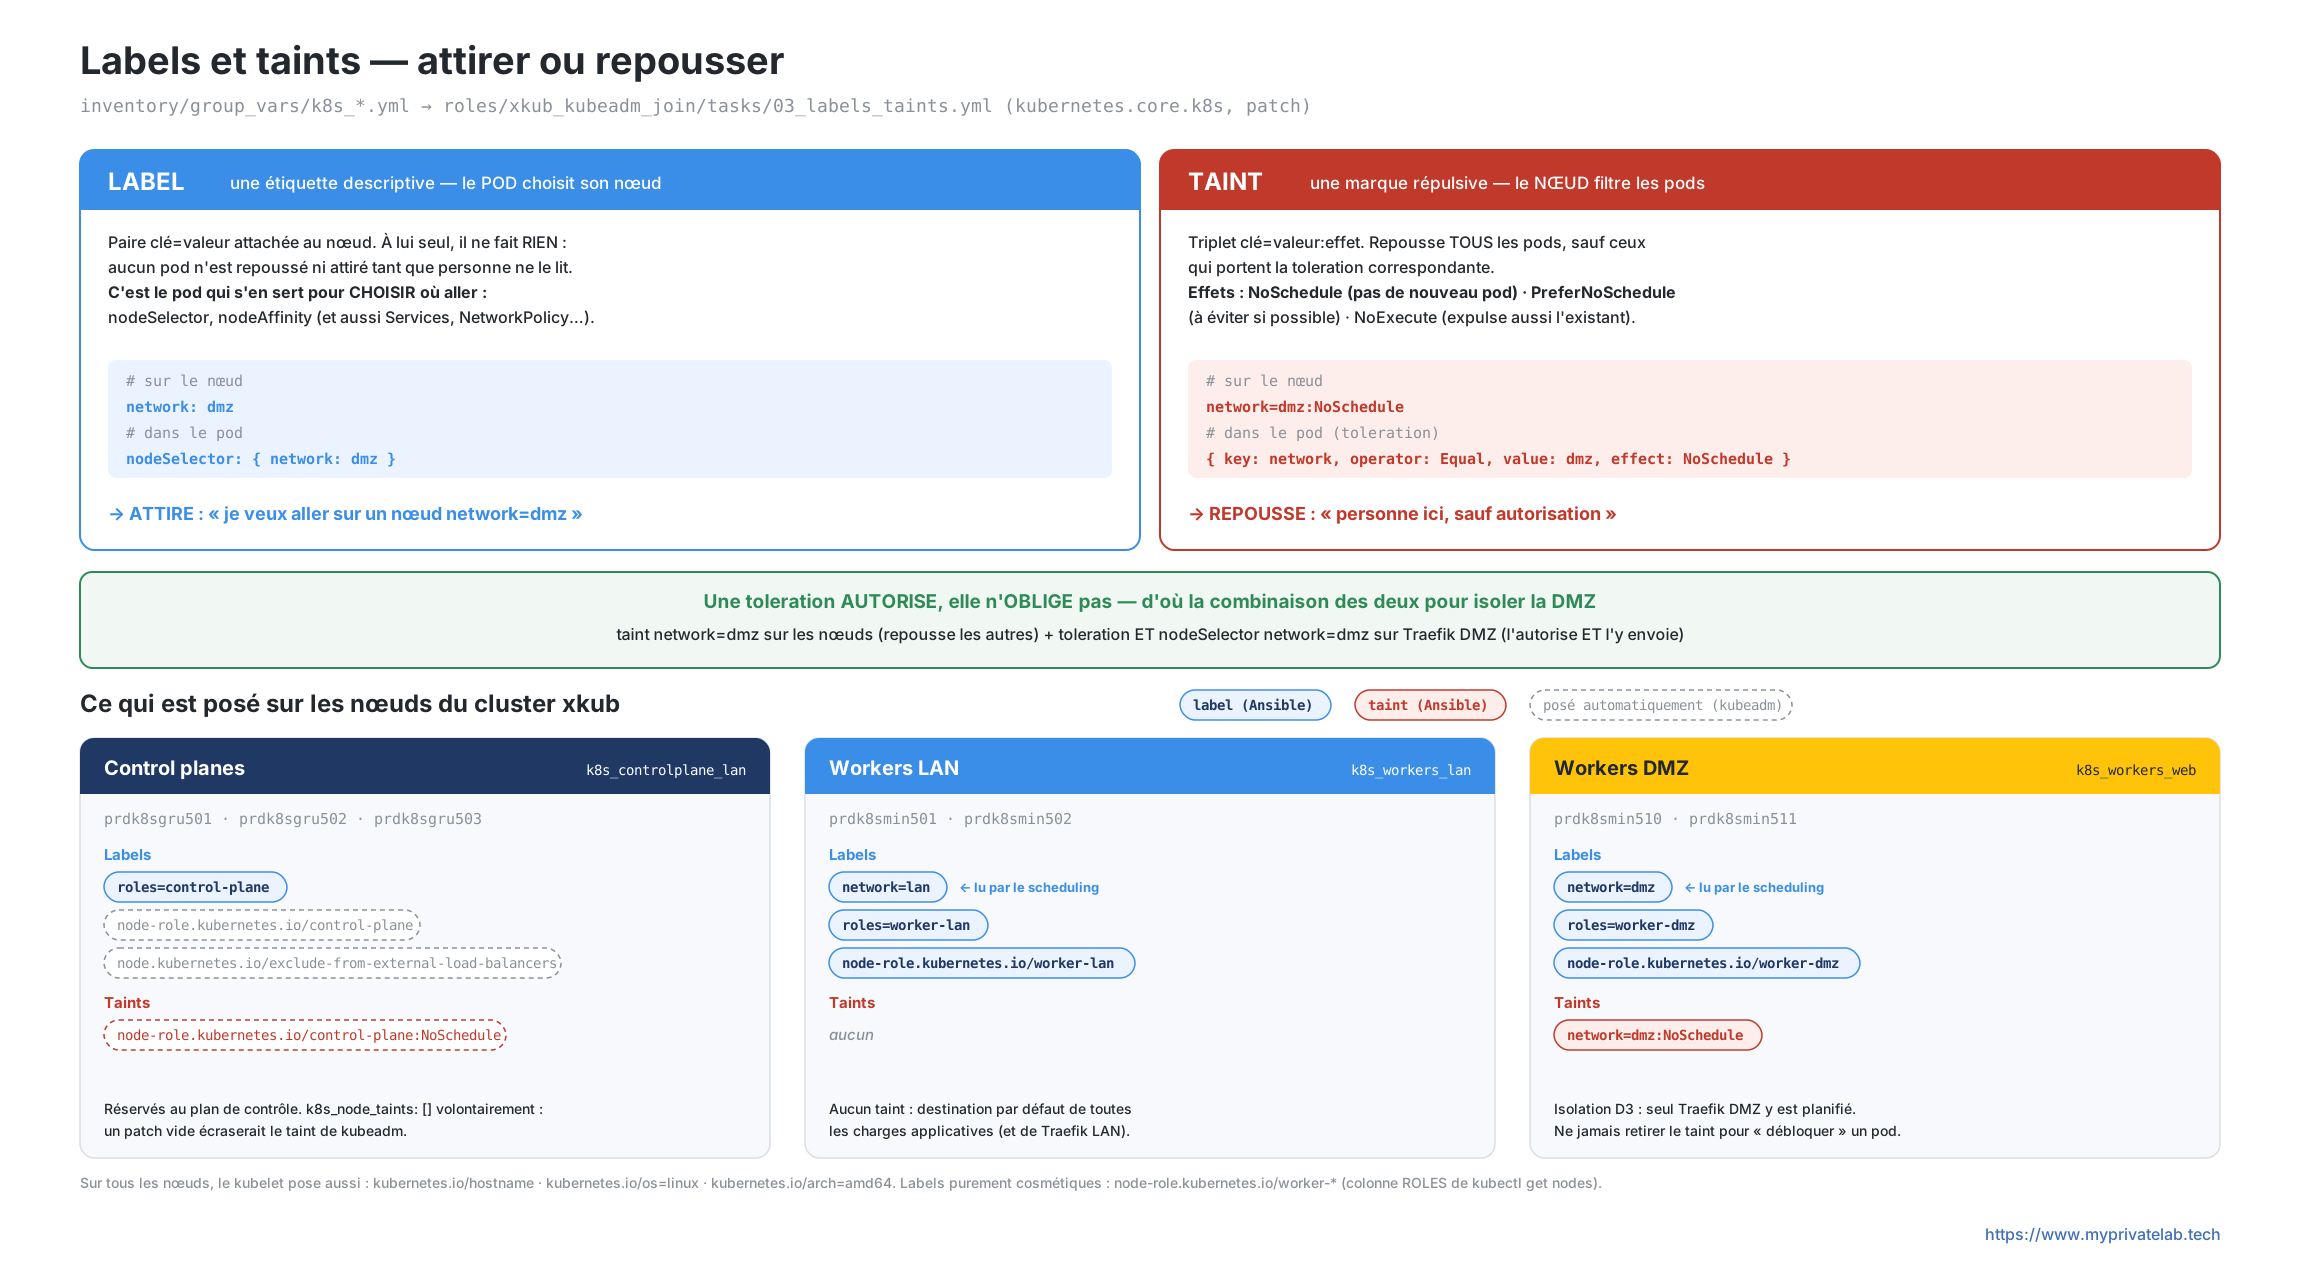
Un label est simple à comprendre. C’est une paire clé/valeur que l’on assigne à un objet K8S, dans notre cas un node. C’est une manière d’étiqueter un serveur (ou un autre objet Kubernetes) pour par la suite l’identifier facilement ou le classifier. On peut associer à un serveur autant de labels qu’on souhaite. Par exemple, dans notre cas, le label network=lan pour les worker du lan, et network=dmz pour les worker exposés sur le web (voir architecture). Par la suite on pourra explicitement préciser que telle ou telle application doit s’exécuter sur un node dont le label correspond à network=le_reseau_souhaité.
Cependant, un label ne peut pas garantir qu’un asset s’exécutera uniquement au bon endroit. Si on reste sur notre exemple du réseau, on peut imposer à une application de tourner sur un node associé à un réseau spécifique en exploitant un label, cela sous-entendant qu’on a explicitement indiqué cette information. Dans le cas où on ne préciserait rien, Kubernetes aurait la liberté de sélectionner lui-même le node de destination de l’application avec le risque, par exemple, qu’une application destinée au lan se retrouve sur un node en dmz. En réalité, nous souhaitons éviter que cette situation se reproduise, même si nous omettons de spécifier le label du nœud à utiliser pour notre application. C’est à ce moment-là que les taint entrent en scène.
Un taint est une restriction appliquée à un nœud. Si un nœud dispose d’un taint, alors il « repousse » automatiquement tous les pods sauf ceux qui posséderaient une « toleration » à ce taint. En gros, c’est « Accès interdit à tout le monde, sauf si vous avez le badge (toleration) pour entrer ».
Par exemple, les control plane ont un taint par défaut « node-role.kubernetes.io/control-plane:NoSchedule ». Dans cette notation on retrouve.
- La clé : node-role.kubernetes.io/control-plane (identifie le rôle du nœud).
- L'effet : NoSchedule (indique à Kubernetes de ne programmer aucun nouveau pod sur ce nœud, à moins que le pod ne possède la toleration exacte pour cette clé).
- Par défaut, un control plane ne peut pas être utilisé pour exécuter un pod applicatif que vous auriez déclaré, à moins que, dans la configuration de ce pod, vous spécifiez une toleration propre à cette clef, ce qui donnerait en yaml pour ce pod spec :
tolerations: - key: "node-role.kubernetes.io/control-plane" operator: "Exists" effect: "NoSchedule"- key : Cela cible précisément l’étiquette de protection du control plane.
- operator: "Exists" : indique à Kubernetes qu'il suffit que cette clé soit présente sur le nœud pour que la toleration soit valide (il n'est pas nécessaire de vérifier une valeur précise).
- effect: "NoSchedule" : corresponds à la restriction du taint que le pod doit contourner
C’est exactement le même mécanisme qu’on va utiliser pour empêcher une application de tourner sur un node en DMZ sauf à ce qu’elle est la bonne toleration dans sa configuration.
Sur les serveurs en DMZ on va placer via cette tache Ansible, le taint network=dmz:NoSchedule, ainsi pour qu’un pod puisse se lancer en DMZ, il faudra à la fois préciser le label network=dmz pour qu’il sélectionne un node qui dispose de ce dernier et, en plus avoir un toleration qui lève le taint appliqués pour les workers de dmz. Ainsi, si on ne précise rien, le pod sera automatiquement rejeté en dmz.
Un petit tour par l’IA et voici un schéma qui résume le tout.
Cliquez sur l'image pour l'agrandir.
À noter qu’on utilise pour ces taches le module Ansible « kubernetes.core » qui justifie le pourquoi des bibliothèques Python déployées lors de la phase précédente en même temps que l’initialisation du cluster. On déroule d’ailleurs ces commandes uniquement depuis prdk8sgru501 via l’instruction delegate_to: "{{ xkub_kubeadm_join_primary_controlplane }}"
En gros cela revient à passer des commandes du type :
kubectl label nodes <nom-du-noeud> <clé>=<valeur>
kubectl taint nodes <nom-du-noeud> <clé>=<valeur>:<effet>
Ceci en étant connecté sur prdk8sgru501
Conclusion
Pas d’autres éléments à décrire pour ce rôle, finalement relativement simple, puisqu’il permet simplement d’ajouter les nodes aux clusters et d’appliquer les bons taints et les bons labels en fonction des choix d’architecture associés au cluster.
C’était néanmoins l’occasion de présenter certains concepts clefs. Une fois de plus on a pu s’appuyer sur une ossature Ansible proposée par l’IA fonction d’instructions humaines explicites pour détailler des éléments de fonctionnement associés à K8S.
A ce stade si on devait résumer ce qui a été fait en incluant l’étape précédente pour initier le cluster, voici les commandes équivalentes à ce qui a été présenté sous forme de roles Ansible.
| # | Nœud | Commande | But |
|---|---|---|---|
| 1 | CP1 (prdk8sgru501) | kubeadm init --config /etc/kubernetes/kubeadm-config.yaml --upload-certs --skip-phases=addon/kube-proxy |
Crée le cluster. --upload-certs chiffre les clés des CA dans le Secret kubeadm-certs. Pas de kube-proxy, car Cilium le remplace. |
| 2 | CP1 (prdk8sgru501) | mkdir -p ~/.kube |
Rend kubectl utilisable sur CP1 |
| 3 | CP1 (prdk8sgru501) | sed -i 's#super-admin.conf#admin.conf#' /etc/kubernetes/manifests/kube-vip.yaml |
kube-vip revient au kubeconfig normal une fois l'init terminé |
| 4 | CP1 (prdk8sgru501) | kubeadm token create --print-join-command |
Affiche la commande de join complète : token + hash de la CA (token valable 24 h) |
| 5 | CP1 (prdk8sgru501) | kubeadm init phase upload-certs --upload-certs --config /etc/kubernetes/kubeadm-config.yaml |
Ré-uploade les certificats et affiche une nouvelle certificate-key (valable 2 h) |
| 6 | CP2 (prdk8sgru502), CP3 (prdk8sgru503) (un à la fois) |
kubeadm join xkub.coolcorp.priv:6443 --token <token> --discovery-token-ca-cert-hash sha256:<hash> --control-plane --certificate-key <clé> --apiserver-advertise-address <IP du nœud> |
Ajoute un control plane : récupère les clés des CA, crée les static pods, ajoute un membre etcd |
| 7 | Workers prdk8smin501, 502, 510, 511 |
kubeadm join xkub.coolcorp.priv:6443 --token <token> --discovery-token-ca-cert-hash sha256:<hash> |
Ajoute un worker (TLS bootstrap du kubelet seulement) |
| 8 | CP1 (prdk8sgru501) | kubectl label node prdk8sgru50{1,2,3} roles=control-plane |
Label des CP |
| 9 | CP1 (prdk8sgru501) | kubectl label node prdk8smin50{1,2} network=lan roles=worker-lan node-role.kubernetes.io/worker-lan= |
Labels des workers LAN |
| 10 | CP1 (prdk8sgru501) | kubectl label node prdk8smin51{0,1} network=dmz roles=worker-dmz node-role.kubernetes.io/worker-dmz= |
Labels et taint d'isolation des workers DMZ |
On arrive presque au bout du playbook destiné à la mise en œuvre de base du cluster, mais avant de pouvoir passer à son exécution réelle, on va devoir terminer par le rôle xkub_cilium dédié au déploiement du CNI (Container Network Interface) : c’est prévu pour le prochain article.